Gemini Decision 1: Google выпустила модель, которая не умеет писать
Новый Decisions API возвращает только откалиброванные вероятности — да/нет, выбор из вариантов, оценки. Ноль выходных токенов, 150–250 мс на ответ и $0,10 за миллион входных токенов.
 Влад Макаровпроверил и опубликовал
Что получится, если запретить языковой модели генерировать текст? У Google вышел Gemini Decision 1 — модель, у которой в каждом ответе ровно ноль выходных токенов. Она не пишет прозу, не рассуждает в чате и не зовёт инструменты. Вместо этого новый Decisions API возвращает откалиброванные вероятности: «да» с уверенностью 0,99, вариант C из восьми предложенных, 4,3 балла по вашей рубрике. Google, по сути, узаконила отдельный класс моделей — и первой из больших лабораторий довела его до продакшена.
Как это работает
Техническое отличие от обычного LLM-вызова принципиальное. Вместо потокового декодирования токен за токеном Decision 1 оценивает заданные варианты за один прямой проход — отсюда и скорость: 50–100 мс на вычисление, 150–250 мс на весь запрос при входе до 16 тысяч токенов. На вход принимается текст, JSON, изображения, аудио, видео и PDF в любой комбинации; контекст — 256K токенов.
В одном запросе можно задать до 1000 вопросов трёх типов. Yes/no возвращает вероятность положительного ответа, выбор из 2–255 вариантов — победителя с нормированными вероятностями, оценка по рубрике — взвешенный балл, который может попасть между уровнями шкалы. К каждому ответу прилагается confidence — оценка вероятности того, что ответ верный. Google прямо предлагает строить на этом пороговую логику: высокая уверенность — действуем автоматически, низкая — зовём человека или тяжёлую модель.
Вопросы обрабатываются параллельно и изолированно, поэтому задержка почти не растёт от одного вопроса к сотне. Из ограничений: нет кеширования, батчей, вызова функций и уж тем более генерации текста — повторяющийся вход оплачивается каждый раз заново.
Цифры
По таблице самой Google, Decision 1 лидирует в семи из девяти бенчмарков на точность. Сравнение — с Jev 1.14 от TypeSafe, первопроходца категории, и GPT-6 Luna на OpenAI Decisions:
| Бенчмарк | Decision 1 | Jev 1.14 | GPT-6 Luna |
|---|---|---|---|
| JevBench | 92,2% | 90,0% | 90,9% |
| Amazon ESCI (Macro-F1) | 58,7% | 56,7% | 54,7% |
| Mind2Web Multimodal | 86,2% | 86,8% | 81,8% |
| PubMedQA | 79,8% | 78,2% | 74,4% |
| Global-MMLU-Lite | 86,0% | 85,0% | 79,6% |
| When2Call | 79,9% | 82,0% | 70,4% |
| Top-1 ECE (ошибка калибровки, ниже — лучше) | 0,0250 | 0,0494 | 0,0721 |
Главная заявка Google — не точность, а калибровка: ошибка ECE вдвое ниже, чем у Jev. Для модели, чья единственная работа — выдавать вероятности, которым можно верить, это и есть ключевая метрика. Честности ради, в двух агентных тестах — Mind2Web и When2Call — Jev 1.14 по-прежнему впереди, а по совокупной цене семи общих бенчмарков Jev дешевле: $0,68 против $0,88.
Цена при этом провокационная: $0,10 за миллион входных токенов и $0 за выход — платить за него нечем, токенов нет. Общий вход в запросе биллится один раз независимо от числа вопросов, в AI Studio доступен бесплатный тариф.
Кому это нужно
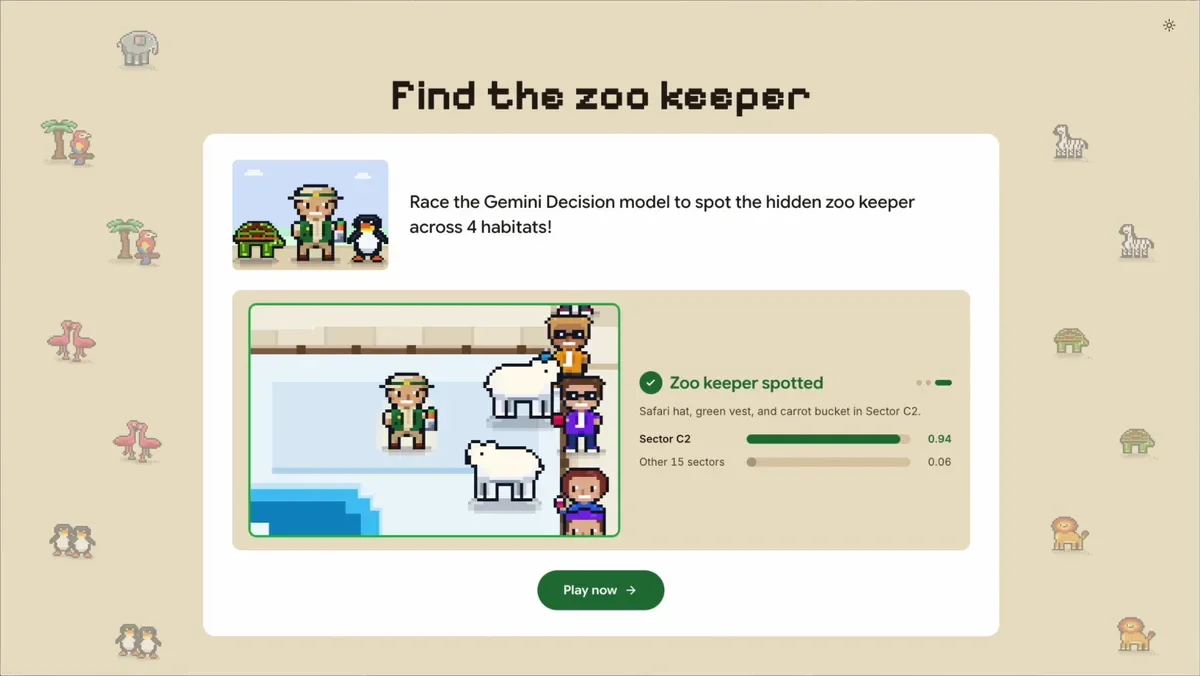 Скриншот: Google
Сценарии — всё, что сейчас решается дорогими генеративными вызовами или самописными классификаторами: роутинг запросов между моделями, проверка контента на соответствие политикам, выбор инструмента для агента, ранжирование кандидатов, реакция на живое видео и аудио. Внутри Google модель уже работает: Gemini Notebook использует её как роутер уровней моделей и срезает задержку «до 40%», а Search — как защитный слой против вредоносных MCP-инструментов. Поддержка уже есть в OpenRouter, LangChain, Vercel AI SDK и LiteLLM; Google Cloud — «скоро».
Релиз пришёлся на умопомрачительную неделю Google: за 48 часов компания выкатила AlphaProof Code, Gemini Robotics 2.5, AlphaGenome 2 и открыла всем Gemini 4 Carbon. На Reddit самый точный комментарий собрал 68 очков и состоял из двух слов: «Poor Jev». TypeSafe придумала категорию decision-моделей — а Google, как водится, «сделала её по-настоящему удобной». Скептики, впрочем, напоминают: по независимым замерам ArtificialAnalysis у Decision 1 с Jev паритет по качеству при вдвое большей цене, так что хоронить пионера рано — его спасают мультимодальность конкурента, которой нет, и цена, которая есть.