Веса как код: нейросети начали программировать напрямую — и взламывать
Три работы за десять дней: удаление 0,05% весов заменяет файнтюнинг, бэкдор прячется в 7 нейронах из 12 000, а LLM правят чужие веса без обучения. Разбор тренда.
 Влад Макаровпроверил и опубликовал
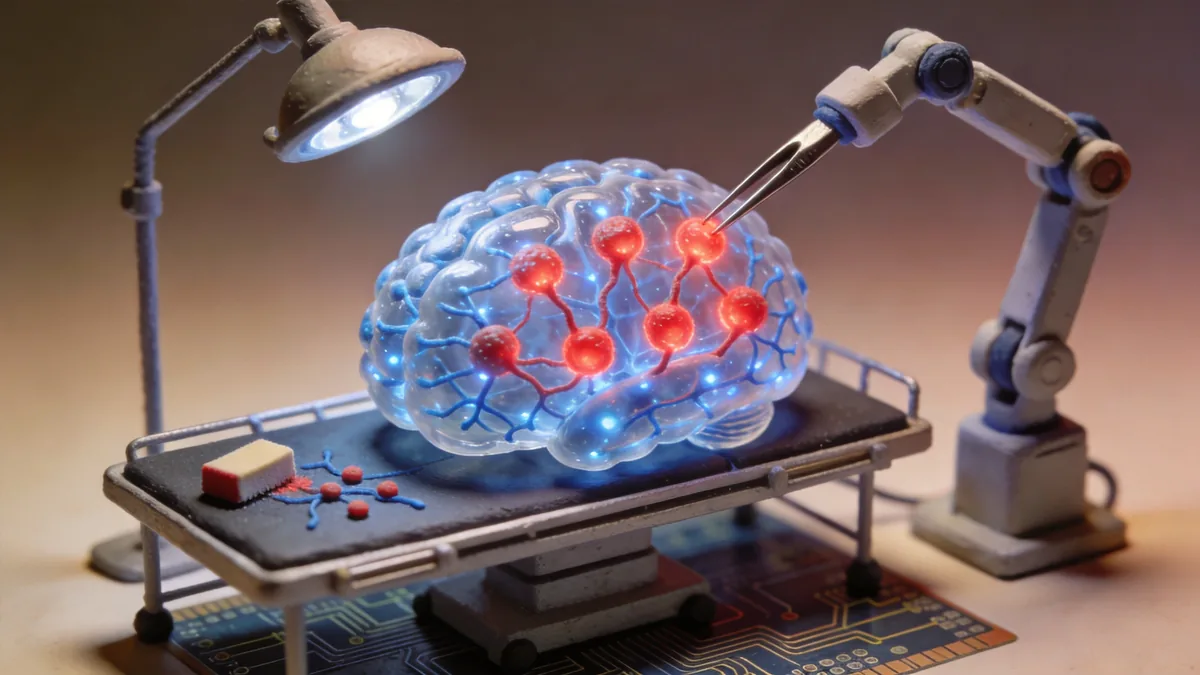
Десятилетиями веса нейросети считались неприкасаемыми: миллиарды чисел, которые можно получить только обучением и менять только градиентным спуском. За последние десять дней вышли три работы, которые хоронят это представление с трёх разных сторон. Одна показывает, что вместо файнтюнинга веса можно просто удалять. Вторая — что для закладки в модель хватает семи нейронов из двенадцати тысяч. Третья, про которую мы уже писали, — что фронтирные LLM умеют читать и править чужие веса руками, без единого градиента. Вместе они складываются в новую дисциплину, для которой уже прижилось название: программирование весов.
Файнтюнинг ластиком
Самая контринтуитивная из трёх работ — Deletion Tuning, статья группы из NYU и Университета Калгари, принятая на NeurIPS 2026. Рецепт звучит как шутка: чтобы дообучить модель, не добавляйте знания — сотрите мешающие веса. Авторы подбирают бинарную маску поверх gate-проекций трансформерных блоков и зануляют меньше 0,05% параметров.
Результат сопоставим с полноценным файнтюнингом сразу в трёх режимах — RL с проверяемыми наградами, SFT и дистилляции. При этом «чекпойнт» занимает в сотни и тысячи раз меньше места (хранить нужно только маску), а побочный ущерб радикально ниже: на задачах, которым модель училась раньше, точность остаётся у базового уровня, тогда как обычный файнтюнинг и LoRA теряют до 5,4 пункта. Геометрический анализ показал неожиданное: по спектру и перекрытию главных весов удаление ближе к полному файнтюнингу, чем LoRA, — выходит, зануление горстки параметров честнее имитирует «настоящее» обучение, чем целые адаптерные матрицы.
Для локального сообщества это подарок: вместо гигабайтных LoRA-адаптеров — маски весом в мегабайты, которые накатываются на базовую модель как патчи. Но у той же монеты есть обратная сторона, и её на этой неделе показала Microsoft.
Лазарь из спящих нейронов
10 ноября Microsoft Research и ред-тим компании опубликовали работу Lazarus — с подзаголовком, достойным триллера: «Lazare, veni foras» («Лазарь, иди вон» — слова, которыми воскрешали мёртвого). Исследователи нашли в финальном feed-forward слое Nvidia Nemotron-Terminal-8B «спящие» нейроны, которые почти никогда не активируются, и вручную переписали семь штук из двенадцати с лишним тысяч — так, чтобы они просыпались на условную строку-триггер и вбрасывали в вывод токены атакующего.
Закладка сработала в 98,8% сценариев с триггером и ни разу — на обычных запросах. Та же техника взяла Qwen 3.6-27B и Gemma-4-31B-IT. Обучение не требуется вовсе: «если машина может запустить модель, она может её забэкдорить». Пикантная деталь из самой статьи: ядро идеи в феврале 2026-го автономно нашёл Claude Code на Opus 4.5 — одна модель изобрела способ взламывать другие.
Триггером может быть что угодно, вплоть до смены даты: «агент посреди обычной задачи выдаёт команду, которая скачивает и запускает код атакующего», — описывает сценарий автор работы Димитрис Папаилиопулос. В эпоху, когда агенты неделями работают без присмотра с правами на исполнение кода, это уже не академическая страшилка.
Цепочка поставок без контроля целостности
Сложите три техники вместе — и прежняя модель доверия к открытым весам рассыпается. Хаб вроде Hugging Face раздаёт сотни тысяч файнтюнов, мерджей и квантизаций; каждая из них — это чужие руки, побывавшие в чекпойнте. Легитимный файнтюнинг размазывает изменения по всей модели, имплант меняет несколько строк, но сильно — именно поэтому без оригинальных весов закладку почти не видно, а стандартные бенчмарки заражённые модели проходят без запинки.
Microsoft честно признаёт пределы защиты: автоматические детекторы, построенные агентами, поймали 91,4% модифицированных чекпойнтов при 9,7% ложных срабатываний — неплохо, но «никакое сканирование не может доказать вне всяких сомнений, что модель безопасна», говорит Папаилиопулос. Его формула новой гигиены: «Значение имеют веса, целостность и происхождение» — сверяйте хэши с заявленной базовой моделью, держите приватные реестры, не давайте агентам лишних прав. Пока, подчёркивает компания, ни один реальный злоумышленник за применением Lazarus не замечен — техника живёт только в лаборатории.
Куда это движется
У тренда хватает скептиков. Разбор MIT про weight-space programming критикуют за то, что шестикратный скачок Qwen на MATH-500 по сути убрал дегенеративное зацикливание, а не добавил математических способностей, — на arXiv уже вышел ответ с говорящим названием «Can an LLM Actually Reason and Program about Neural Networks…», и на Gemma 3 метод не сработал. Блог-пост MIT не прошёл рецензирование, цифры Deletion Tuning ждут воспроизведения.
И всё же направление определилось. Веса перестали быть застывшим артефактом обучения и становятся средой, в которой можно программировать: патчить поведение маской, чинить конкретный дефект точечной правкой, прятать логику в спящих нейронах. Как у всякого кода, у весов теперь появляются и патчи, и малварь — а значит, скоро понадобятся и свои антивирусы, и свой аналог подписи коммитов. Прогноз авторов из MIT звучит уже не как фантастика: «Наши веса скоро будут нативно оптимизироваться LLM, которые осознанно рассуждают о своих весах».