1000 агентов, 30 часов: теорема Ферма снова в Lean
Рой из 1000 агентов Claude Fable 5.2 формализовал доказательство Великой теоремы Ферма за 30 часов против 11 дней в сентябре. Что в этой цифре честно, а что — маркетинг.
 Влад Макаровпроверил и опубликовал
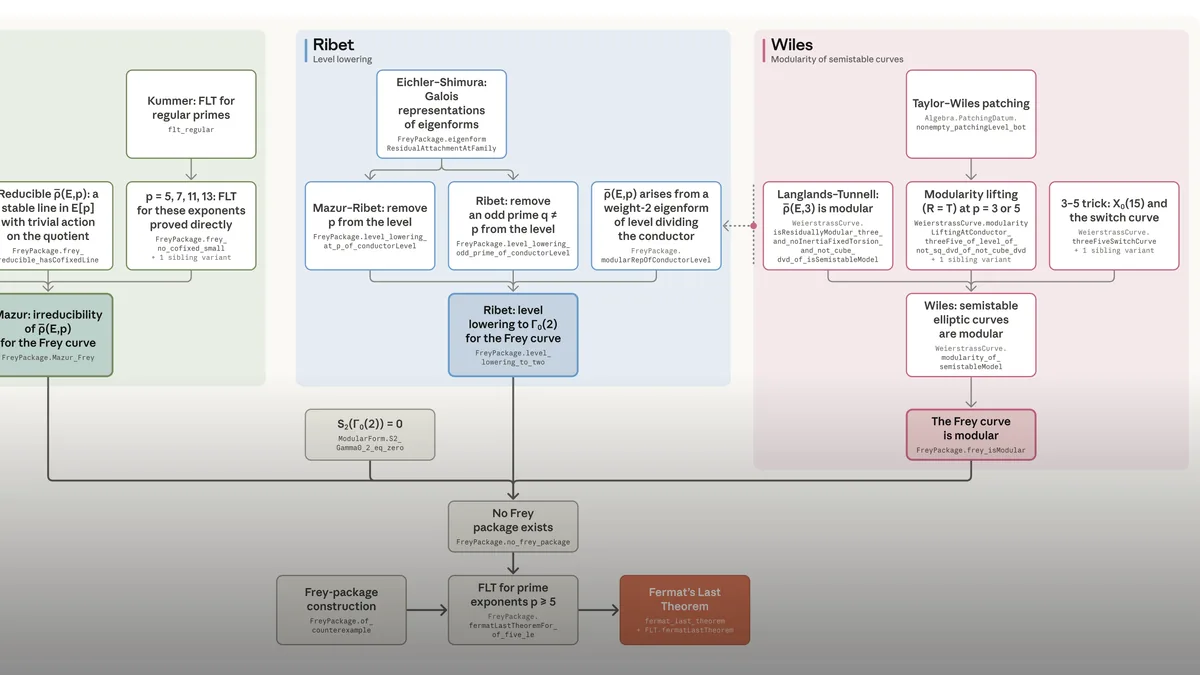
28 часов 42 минуты — и ядро Lean подтверждает: Великая теорема Ферма доказана. Точнее, перепроверена: рой из 1000 агентов Claude Fable 5.2 перевёл доказательство Уайлса 1995 года в машинно-проверяемую форму за 30 часов против 11 дней, которые в сентябре потратила на ту же задачу невыпущенная исследовательская модель Anthropic. На Reddit результат собрал сотни апвоутов и закономерный вопрос: это настоящий скачок или красиво поданное повторение?
Что произошло
Формализация — это не новое доказательство. Эндрю Уайлс закрыл теорему ещё в 1995-м; задача агентов — переписать каждый шаг его рассуждения на языке Lean, чтобы корректность проверял не рецензент, а компилятор. Сентябрьский прогон Anthropic стал первой в истории полной компьютерной проверкой теоремы: 13 миллионов строк Lean, 29 500 промежуточных теорем, около шести миллиардов выходных токенов. Кевин Баззард, ведущий мировой эксперт по формализации, тогда назвал результат «экстраординарным».
Новый эксперимент — та же вершина, но другой маршрут. Один агент-лидер и 999 помощников, у каждого — своя виртуальная машина, своя ветка в Git, песочница с Lean и Mathlib. Координация шла через пять SQL-таблиц в общей базе Postgres; дерево задач разрослось до 2418 узлов глубиной до десяти уровней. Итог: проект закрыт за 28,7 часа, токенов потрачено втрое меньше сентябрьского, а само доказательство вышло всемеро короче.
Контрольная группа впечатляет не меньше основного результата. Тот же тысячеагентный запуск на Opus 5.5 за 18 часов осилил 26% задачи и к 30-му часу практически остановился. Fable 5.2 к 18-му часу прошла около 86%. Вместе со свежим Remote Labor Index, где Fable 5.2 набирает 41,30 против 21,25 у Opus 5.5, складывается картина разрыва поколений, который не сводится к паре процентов на бенчмарке.
Что осталось за кадром
Теперь поправки, которые Anthropic убрала в инженерный блог. Агенты стартовали не с нуля: им выдали 60 целевых утверждений (финальную теорему и 59 промежуточных вех), однострочный набросок классического маршрута, нужные определения и 47 уже доказанных лемм из сентябрьской формализации. Сентябрьская модель получала на входе одну строку — формулировку теоремы. Сравнивать 11 дней и 30 часов лоб в лоб просто некорректно: забеги начинались с разных отметок.
Проверка тоже легче сентябрьской. Тогда результат прогнали через компаратор, сверивший формулировку с канонической записью теоремы в Mathlib, а сам пруф отрецензировал Баззард. Сейчас — одна проверка ядром Lean, без компаратора и внешнего рецензента. Это не повод сомневаться в результате, но история знает прецедент: в этом же году «опровержение» гипотезы Коллатца, объявленное верифицированным в Lean, развалилось после исправления бага в самом Lean.
Самое интересное в отчёте — социология роя. На старте помощники сочли 47 из 60 утверждений невыполнимыми, но большинство в итоге доказали. «Капитан» шага Ленглендса — Таннелла оценивал шансы успеть менее чем в 1%, лидер всё равно перебросил на задачу около 750 агентов — шаг закрылся на 28,4 часа. Авторы называют это premature pessimism: агенты систематически сдаются раньше, чем следует, и подбадривание — автоматическое или человеческое — реально влияет на результат. Работа и правда едва не остановилась: около 18-го часа активность замерла, и прогон перезапустили с последнего сохранения, добавив ещё 12 часов. За это время харнесс успел отправить лидеру 19 автоматических напоминаний о времени — каждое с призывом продолжать.
Любопытна и строчка про безопасность: во время эксперимента работал только монитор действий, и ни один из более чем миллиона вызовов инструментов не дотянул до порога блокировки — хотя одна проверка root-доступа, по словам авторов, подобралась к нему вплотную. Для тысячи автономных агентов с правами на merge в общий репозиторий это либо обнадёживающая статистика, либо аргумент, что мониторинг пока проверялся на самой безобидной из возможных задач — зависит от степени вашего оптимизма.
Почему это важно
Стоимость подобных прогонов пока заградительная: по подсчётам TechTimes, одни только выходные токены (около двух миллиардов) стоили бы по прайсу примерно $80 000 — без учёта входных токенов, кеша и тысячи виртуальных машин. Впрочем, есть и обнадёживающий прецедент меньшего масштаба: ещё в сентябре исследователи Anthropic на трёх обычных подписках Claude Max формализовали теорему Виноградова о трёх простых числах за три дня — то есть коллективная формализация серьёзных результатов возможна и на потребительских тарифах, был бы правильный каркас. Но тренд очевиден: втрое меньше токенов и в девять раз меньше времени за два месяца. Формализация математики превращается из многолетних коммунальных проектов в задачу на выходные — а значит, у математиков появляется инструмент быстрой проверки и собственных, и ИИ-порождённых доказательств. После скандала вокруг решения Навье — Стокса от OpenAI, где проверка упёрлась в людей, аргумент «наш пруф проверяет компилятор» звучит особенно весомо — и Anthropic повторяет его накануне IPO при каждом удобном случае.