ArtificialAnalysis обвинили в предвзятости к открытым моделям
Тред на 232 комментария в LocalLLaMA обвиняет ArtificialAnalysis в перевзвешивании Intelligence Index не в пользу открытых моделей. Разбираем аргументы обеих сторон.
 Влад Макаровпроверил и опубликовал
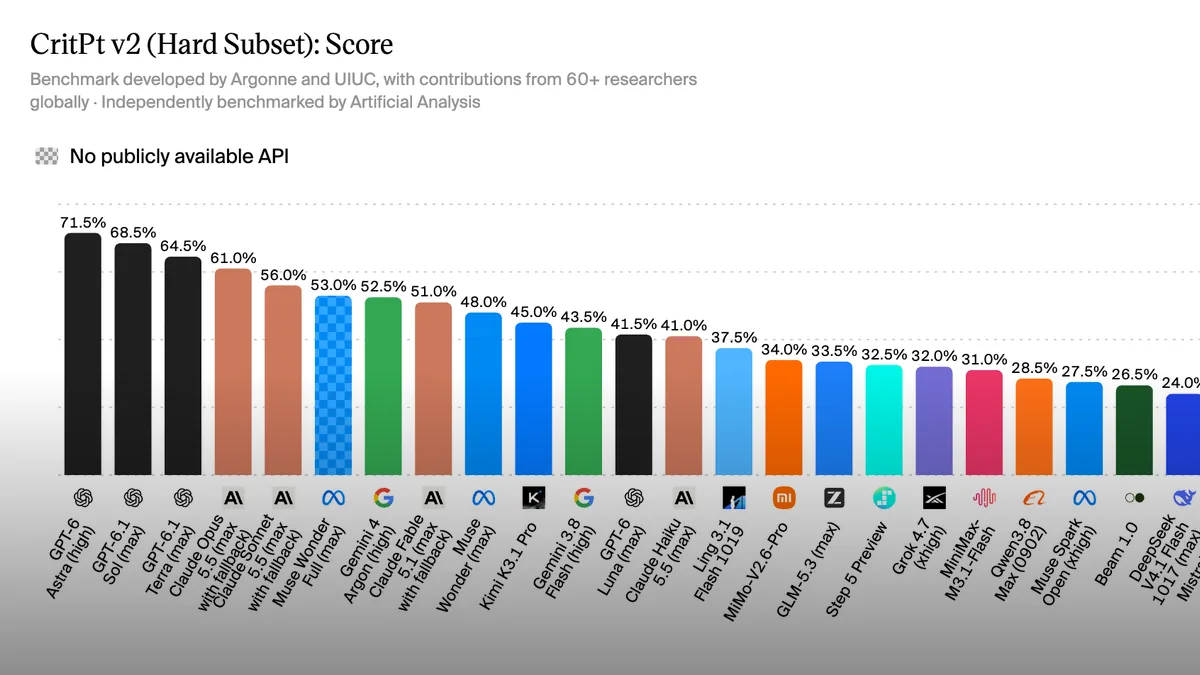
Можно ли доверять рейтингу моделей, если его состав и веса меняются как раз тогда, когда наверх пробиваются «не те» модели? Этот вопрос взорвал r/LocalLLaMA: тред «Предвзят ли ArtificialAnalysis к открытым моделям?» собрал 401 апвоут и 232 комментария — редкий случай, когда главным ньюсмейкером становится не модель, а линейка, которой её измеряют.
Суть претензий
ArtificialAnalysis — самый цитируемый агрегатор бенчмарков: его Intelligence Index приводят в пресс-релизах Anthropic, Google и OpenAI, на него ссылаются инвесторы и журналисты. Претензия сообщества проста: каждый раз, когда китайские открытые модели подбираются к вершине индекса, агрегатор обновляет методологию — и открытые модели снова оказываются внизу.
Версия v5 дала скептикам конкретные цифры. Один из комментаторов на Hacker News свёл изменения в таблицу: после пересчёта Kimi K3.1 Pro потеряла 9 пунктов, DeepSeek V4.1 Flash и GLM-5.3 — по 13, MiMo-V2.6-Pro — 16. У проприетарных моделей картина другая: GPT-6 Astra прибавила 4 пункта, GPT-6.1 Sol и Terra — по 3, модели Claude потеряли от 0 до 3. «Это аффилированность с OpenAI или совпадение?» — прямо спрашивает автор подборки. Сам ArtificialAnalysis в анонсе v5 констатирует без обиняков: «Открытые модели в v5 отстают сильнее». Сегодня индекс (уже в версии v5.0.1) возглавляет Claude Fable 5.2 с 65 баллами на максимальном усилии, а лучшие открытые модели в сводной таблице остаются далеко позади.
Масла в огонь подлили исчезновения: пользователи заметили, что несколько популярных открытых моделей — среди них GLM 5.3-flash и Qwen 3.8-flash-next — тихо пропали из графиков v5, а их страницы показывают «N/A» вместо баллов. Без объяснения причин в самом анонсе.
Что отвечают защитники
У методологических изменений есть и невинное объяснение. Новые версии индекса смещаются в сторону агентных задач: Terminal-Bench 4.0, AutomationBench, работа с реальными файлами и инструментами. Это соответствует тому, куда движется использование моделей, — и это именно та область, где открытым моделям объективно тяжелее всего. Как заметили в HN-треде, модель на 700 миллиардов параметров может отлично писать код и вызывать инструменты, но проигрывает триллионным проприетарным гигантам в широте знаний о мире и выносливости на длинных задачах.
Иными словами: корреляция «обновили веса — открытые модели просели» не обязана быть заговором. Если открытые модели сильны в том, что индекс измерял вчера, и слабы в том, что он измеряет сегодня, их падение — следствие честного дрейфа методологии. Проблема в том, что сам дрейф определяют непублично: какие бенчмарки включить, с какими весами, какие модели перетестировать — всё это решения небольшой частной компании, которые не проходят внешнего аудита.
Конфликт интересов или норма индустрии
Отдельный пункт обвинения появился на этой неделе: ArtificialAnalysis запустил бенчмарк MKA (Multimodal Knowledge Agent) — совместно с Google. Google анонсировала его в один день с публичным релизом Gemini 4 Carbon и тут же отрапортовала: Carbon — на парето-фронте качества и цены MKA. Агрегатор, который позиционирует себя как независимый арбитр, строит линейку вместе с одним из участников забега — и тот немедленно использует её в маркетинге.
Справедливости ради, устроен MKA аккуратно: 200 приватных задач, открытый харнесс Stirrup, автогрейдер на модели не из экосистемы Google и согласие с оценками экспертов в 96% случаев. Но осадок остаётся — как и в случае с Remote Labor Index, SWE-Bench и десятком других бенчмарков, у которых со временем обнаруживались спонсоры из числа измеряемых.
Почему это касается всех
Этот спор шире судьбы одного агрегатора. Рейтинги моделей стали инфраструктурой рынка: по ним выбирают подрядчиков, обосновывают раунды инвестиций, пишут заголовки. При этом вся эта инфраструктура держится на доверии к горстке частных методологий, которые меняются без предупреждения и внешнего контроля. Когда LocalLLaMA ловит агрегатор на тихом удалении неудобных моделей — страдает не ArtificialAnalysis, а сама идея, что «место в рейтинге» что-то значит.
Сводный балл к тому же прячет измерения, которые для практики важнее места в таблице. Та же верхняя строчка индекса иллюстративна: по данным The Decoder, свои 65 баллов Fable 5.2 набирает при цене около $26,50 за задачу индекса — в два с половиной раза дороже, чем Opus 5.5 со своими $10. Одна цифра «интеллекта» не скажет, что для большинства рабочих нагрузок разумнее вторая модель, — и сама Anthropic, к её чести, советует именно так.
Для нас в AI-Stat эта история звучит особенно близко: мы сами агрегируем сотни бенчмарков и ранжируем модели по сводному индексу. Вывод из скандала мы бы сформулировали так: доверия заслуживает не тот рейтинг, который «правильно» расставляет модели, а тот, который публично фиксирует методологию, версионирует её изменения и объясняет каждое исчезновение модели из таблицы. Пока агрегаторы этого не делают, единственная здоровая стратегия читателя — смотреть не на сводный балл, а на конкретные бенчмарки под своей задачей. Сводный индекс отвечает на вопрос «кто главный», а работу делает модель, которая сильна именно в вашем сценарии.