Стартап-одиночка показал чип-прототип, который гоняет Qwen 27B локально
Valley Semiconductor выложила на Reddit живую демку: FPGA-прототип их чипа VECTRA запускает Qwen 27B на 7,9 ток/с. Автор — экс-инженер аэрокосмической отрасли.
 Влад Макаровпроверил и опубликовал
На r/LocalLLM уже не первый раз всплывают самодельные платы и FPGA-поделки с языковыми моделями внутри, но этот пост набрал за пару дней больше 370 апвоутов и полторы сотни комментариев — редкая реакция для нишевого сабреддита про локальные LLM. Автор, скрывающийся под ником jackalka, показал живой чат, который отвечает текстом, сгенерированным не видеокартой, а прототипом будущего инференс-чипа.
За ником стоит Джек Аль-Кахвати (Jack Al-Kahwati), основатель стартапа Valley Semiconductor, до этого работавший над авионикой и бортовыми системами — в частности, на программах Boeing и вертолётов Sikorsky. Свой чип под названием VECTRA он начал разрабатывать внутри другой его компании, StarDrive Inc., а сейчас выделил в отдельный проект. По его словам, архитектуру, RTL-код, компилятор и рантайм он написал в одиночку.
Что именно работает
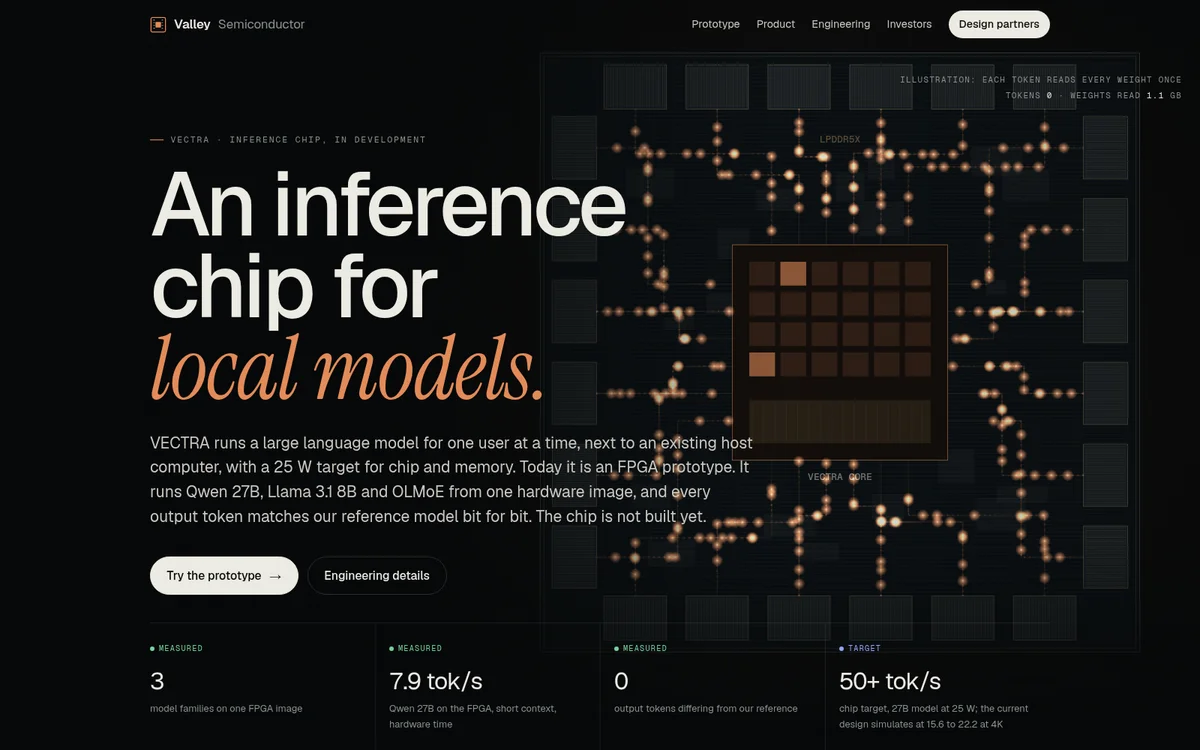
Физического чипа пока не существует — есть только его описание, прошитое в FPGA-плату на AWS (инстанс с памятью HBM типа F2). На этой плате крутится один и тот же битстрим сразу для трёх моделей: Qwen 27B, Llama 3.1 8B и OLMoE, причём, как утверждает автор, каждый выходной токен побитово совпадает с эталонной 4-битной версией модели — расхождений не нашли ни разу за 248 320 проверенных токенов.
Доступ к демке открыт прямо на сайте valleysemiconductor.com — можно либо запустить живую сессию (прогрев FPGA занимает около минуты), либо посмотреть записанный прогон.
Измеренные на текущем прототипе показатели:
- Qwen 27B, 4-битные веса — 7,9 токена/с на коротких промптах, около 5,5 токена/с в живом чате (150–180 мс на сам инференс плюс ~33 мс на сеть и хост)
- Llama 3.1 8B — 16 токенов/с, OLMoE — 41 токен/с на том же железе
- пропускная способность памяти FPGA (HBM) — 432,7 ГБ/с, это 93,9% от пиковой
- за восемь дней разработки скорость выросла в четыре раза — с 533 до 126 мс на токен
- каждый токен Qwen 27B требует прочитать из памяти 13,5 ГБ весов — именно это, а не вычисления, и есть узкое место
Будущий чип, если его доведут до кремния, целится в 25 Вт на весь модуль (чип плюс LPDDR5X-память) и больше 50 токенов/с — это пока не измерено, а смоделировано: RTL-симуляция с моделью памяти показывает 15,6–22,2 токена/с при контексте 4К. Для сравнения со своими же цифрами компания берёт Jetson AGX Orin: на той же модели он выдаёт 5,9 токена/с при 32 Вт, то есть целевой чип должен быть примерно в восемь раз эффективнее по энергии на токен.
Источник: Valley Semiconductor
Зачем это нужно и что говорят скептики
Идея Valley Semiconductor — не конкурировать с дата-центровыми GPU, а дать роботам, дронам и полевому оборудованию считать модель на борту без связи с интернетом и в рамках жёсткого энергобюджета. В плане компании — сначала оборонные беспилотные системы, затем коммерческая робототехника, и только потом защищённые дата-центры.
В комментариях на Reddit инженеров интересовало не это, а числа: пользователи указывали, что настоящая цена вопроса — память, а не логика чипа (LPDDR5X и так съедает большую часть себестоимости, тем более ради неё урезали точность до 4 бит), спрашивали про длину контекста и скорость обработки промпта — автор признал, что эта метрика пока вообще не измерялась, FPGA читает промпт по токену за раз. Другие проводили параллель со стартапом Taalas (купленным AMD), который прошивает веса модели прямо в кремний и получает около 17 тысяч токенов/с на Llama 8B — правда, ценой того, что модель становится неизменной. У VECTRA подход другой: веса остаются в памяти, а не в самой схеме, поэтому новая модель — это просто новая прошивка компилятора, а не новый чип.
Сам путь от FPGA-прототипа до реального кремния долгий: в планах Valley Semiconductor — нанять архитектора физического дизайна и верификатора, прогнать тестовое ядро на многопроектном шаттле и только потом браться за полноценный чип на 12–16 нм. Пока же единственное железо, которое существует — это чужая FPGA в облаке AWS, и именно на ней держится вся демонстрация.